Google의 새로운 AI 의류 시착 도구

Google의 새로운 AI 의류 시착 도구

Google은 사용자가 다양한 체형과 사이즈의 실제 모델에게 옷이 어떻게 보이는지 확인할 수 있는 새로운 가상 입어보기 기능을 발표했습니다.

이 기능은 드레이핑, 접힘, 늘어남, 주름과 같은 디테일이 있는 사실적인 고품질 이미지를 생성하는 새로운 생성 AI 모델을 기반으로 합니다.
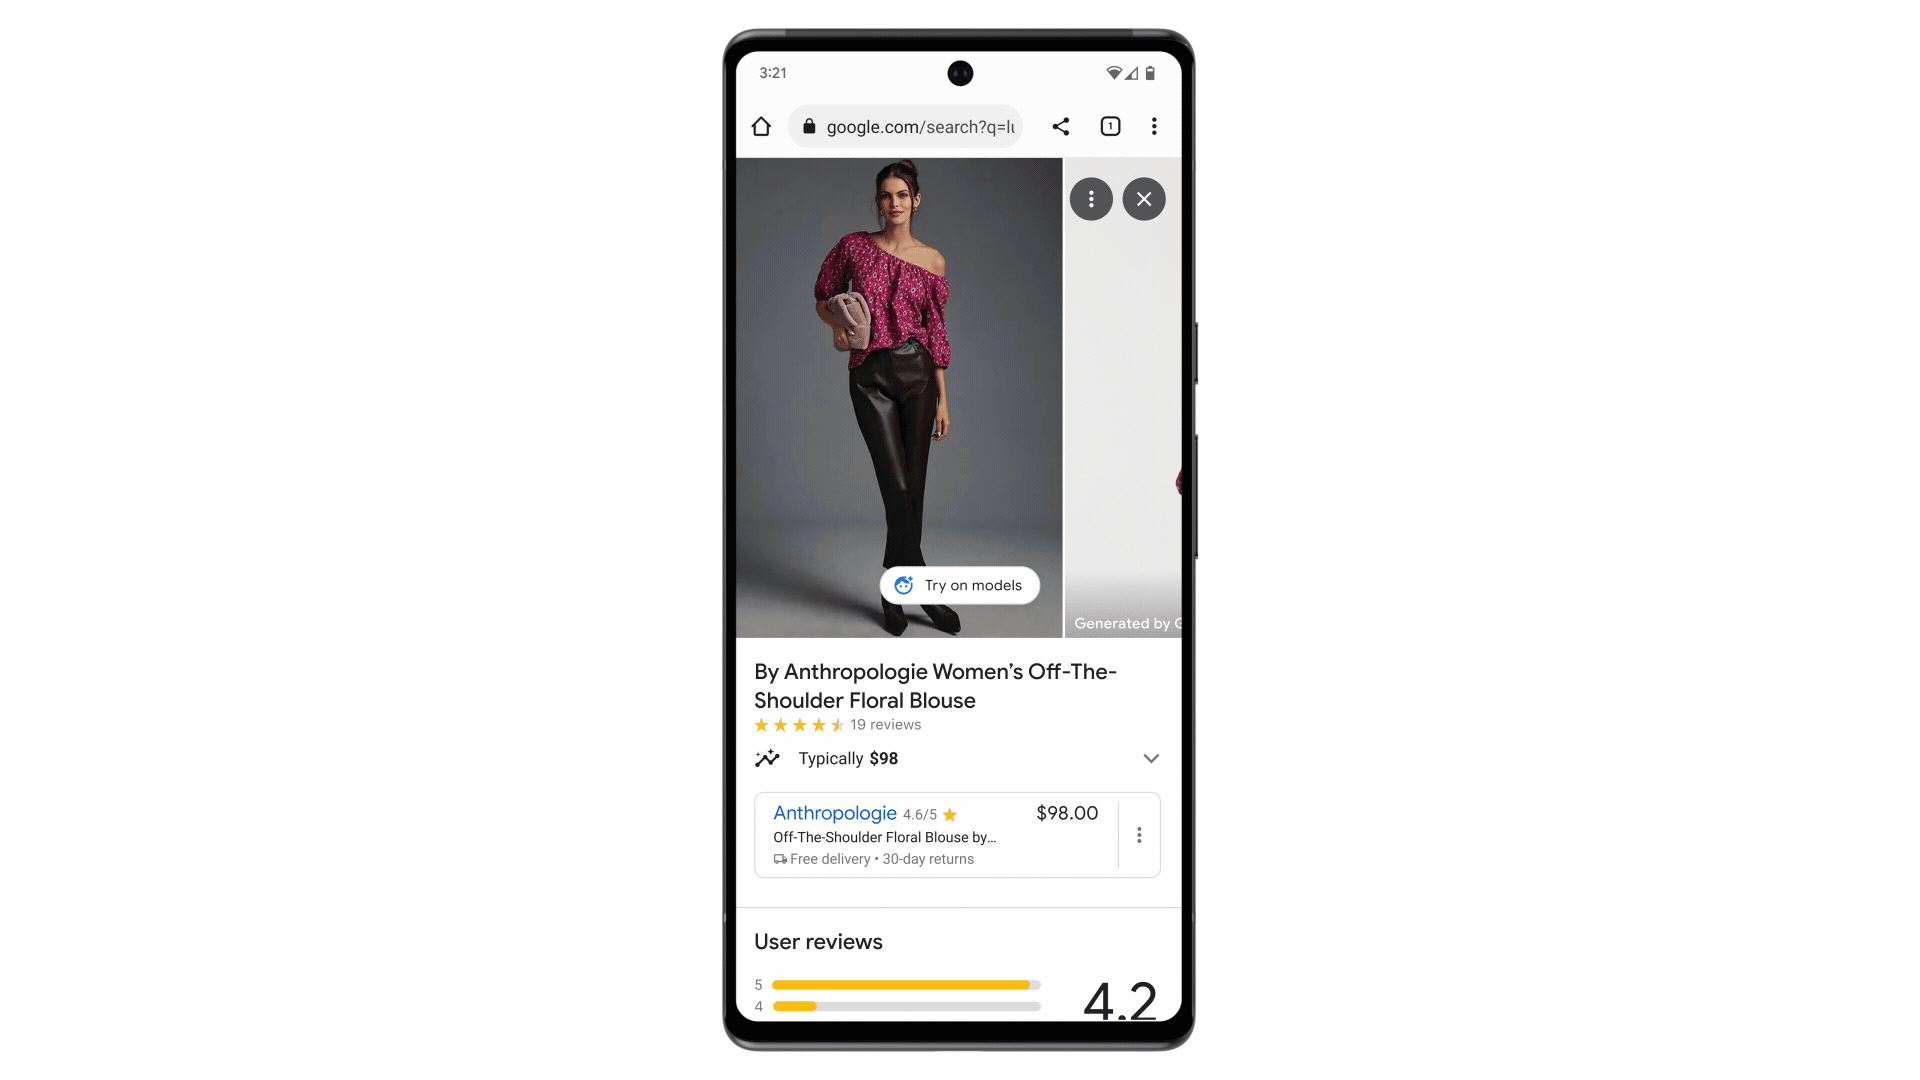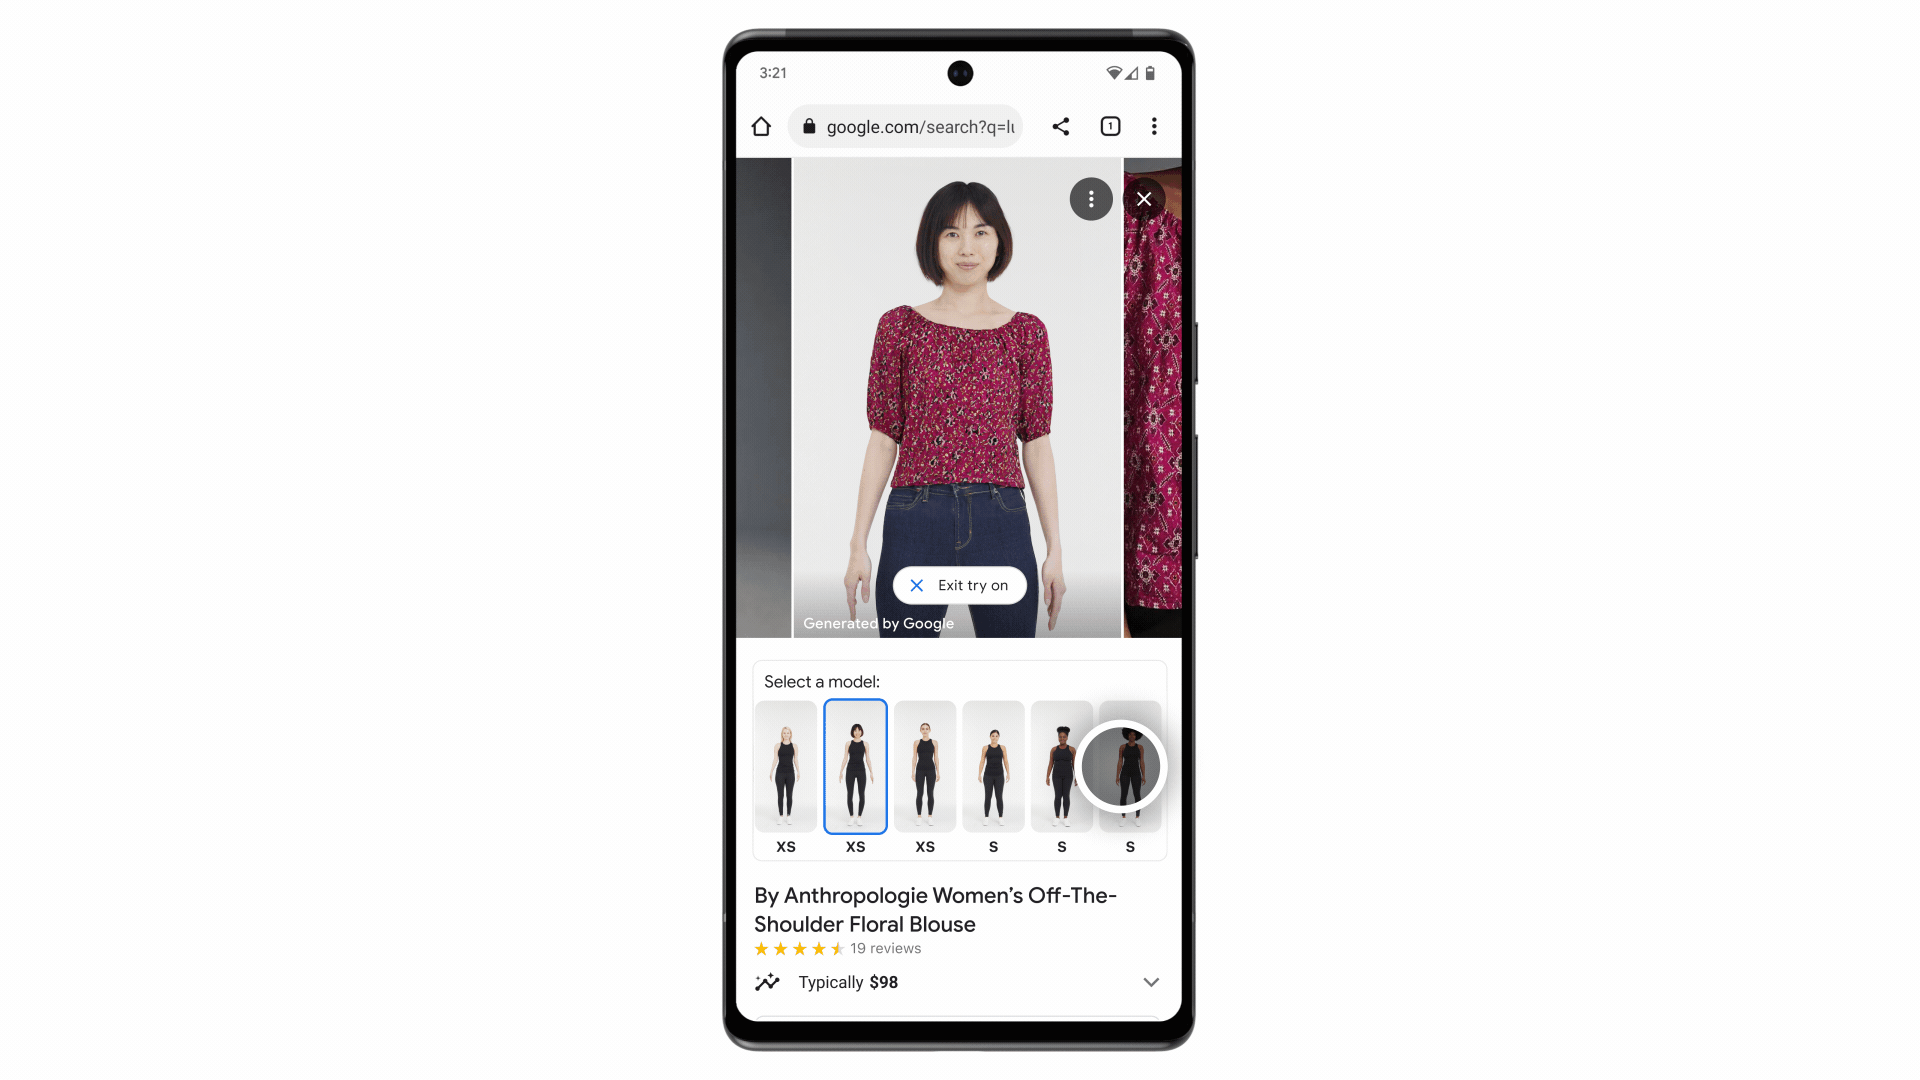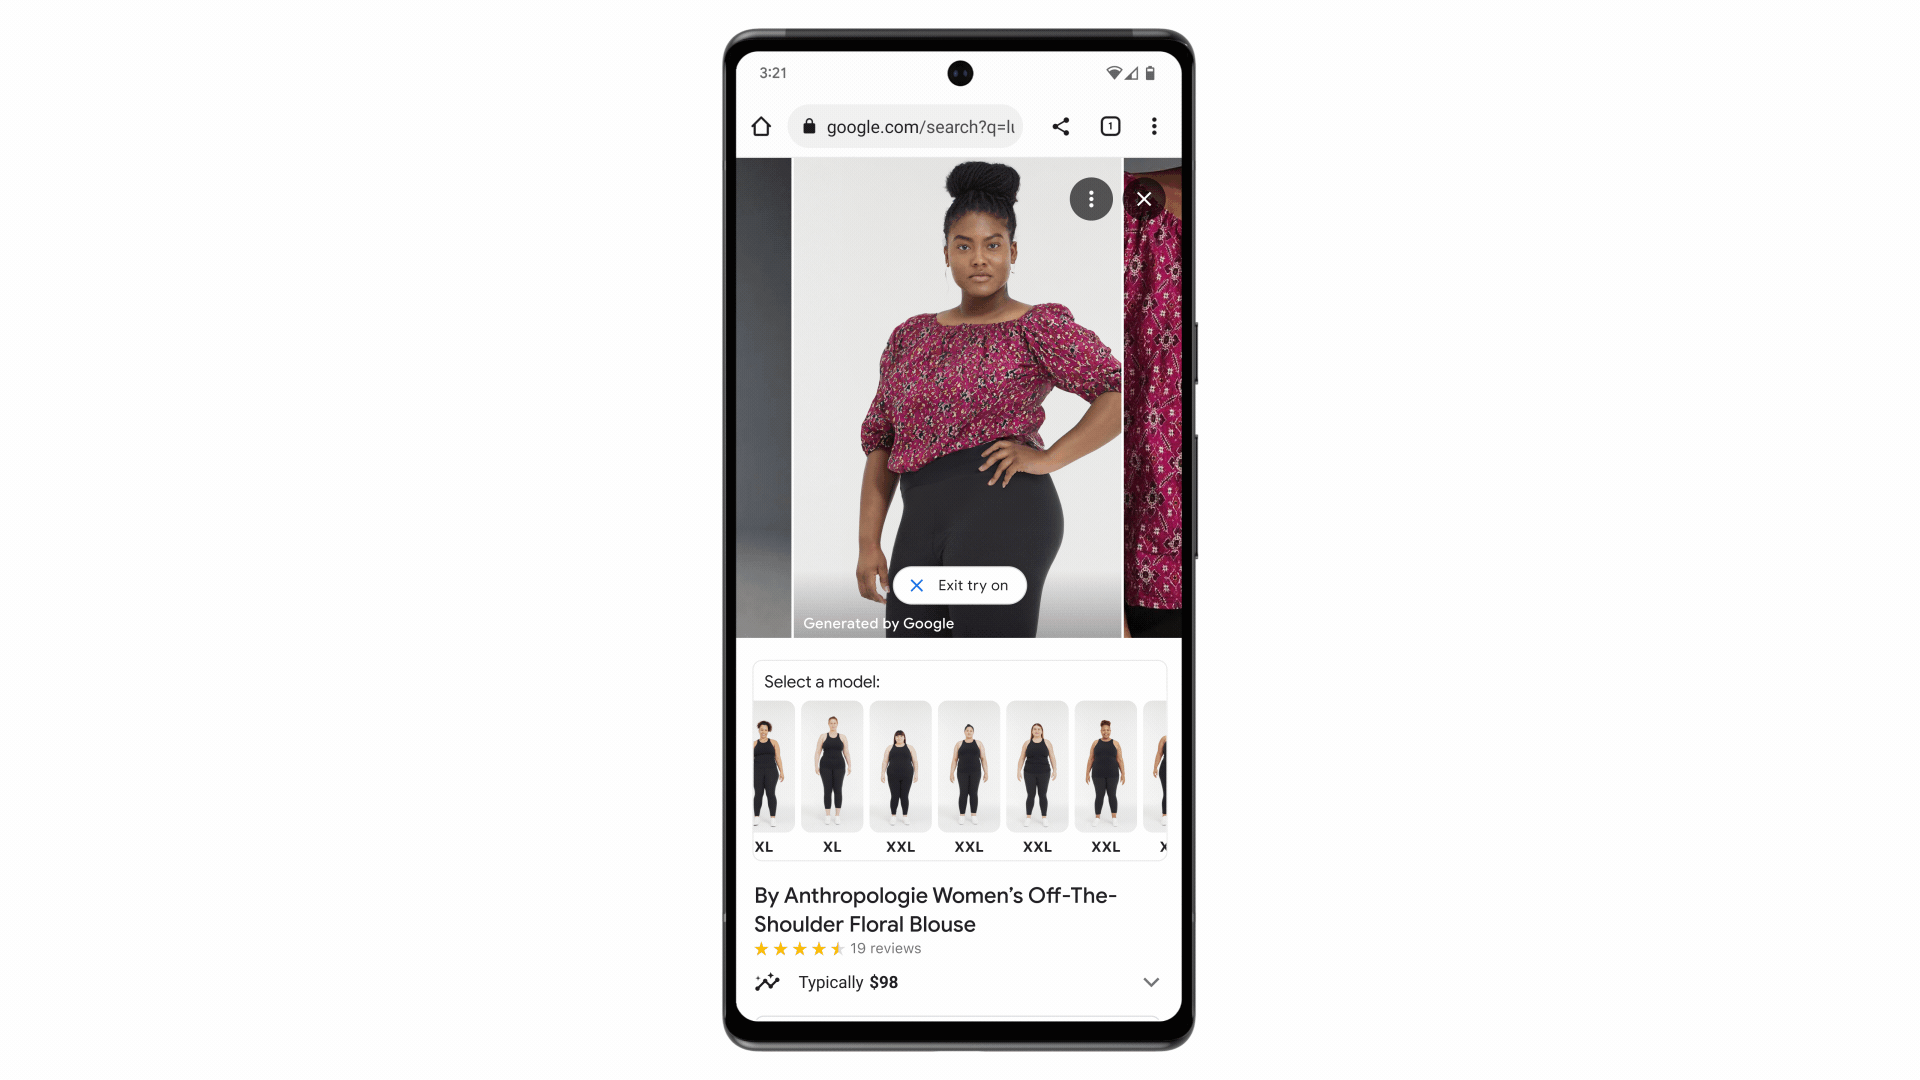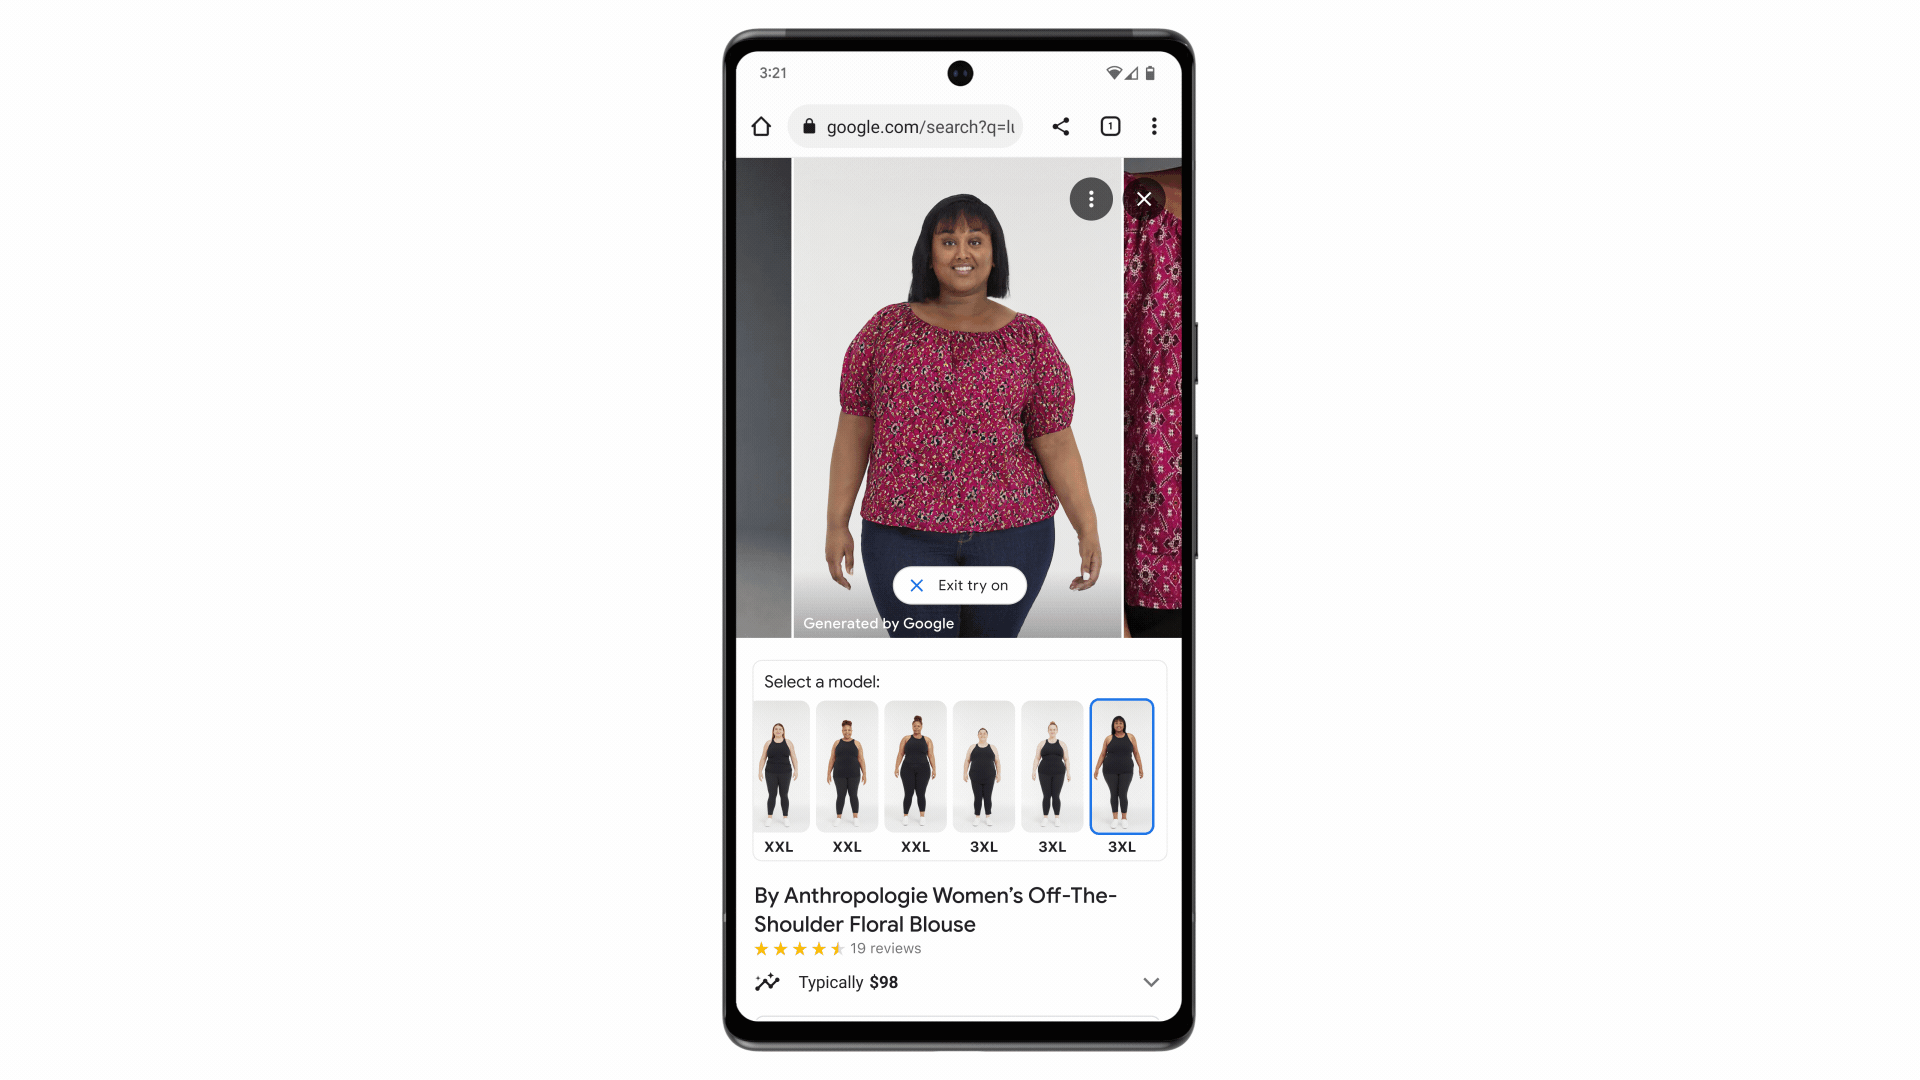
Google의 새로운 AI 의류 시착 도구

이 모델은 제품, 브랜드 및 리뷰에 대한 정보가 포함된 Google의 쇼핑 그래프 데이터 세트를 사용하여 학습되었습니다.

  • 구글이 새로운 AI 기반 의류 가상 착용(VTO) 기능을 발표.
  • 기존 기술의 한계(비현실적인 옷 변형)를 극복하기 위해 확산 모델 + 이미지 입력 + 크로스 어텐션 방식을 도입.
  • 옷 이미지와 인물 이미지를 조합해 픽셀 단위로 사실적인 착용 이미지를 생성.
  • Shopping Graph 데이터를 활용해 다양한 포즈와 사람-옷 조합으로 대규모 학습.
  • 현재 여성 상의부터 시작해 여러 브랜드에 적용, 향후 확대 예정.

Similar Posts

  • 주식 시장에 활력을 불어넣는 AI

    올해 S&P 500 지수의 9%라는 인상적인 랠리를 주도하고 있는 몇몇 종목이 바로 저희가 사랑하는 챗봇인 ChatGPT 덕분에 AI 열풍의 중심에 서 있습니다. AI 주식을 제외하면 S&P 500 지수는 1% 이상 하락할 것입니다(Societe Generale에 따르면). 상승하는 주식: 골드만삭스의 전문가들은 제너레이티브 AI(ChatGPT와 같은)가 널리 도입되면 S&P 500 기업의 이익률이 10년간 약 4% 증가할 것으로 예상하고 있습니다. 관련된…

  • 미드저니 초보자를 위한 몇 가지 기본 사항

    미드저니 배우기 미드저니, 무료 체험판 중단 미드저니를 위한 최고의 리소스 미드저니, 최고의 프롬프트 사이트 추천 미드저니와 달리, 상위 50개 텍스트-이미지 변환 프롬프트 미드저니에서 기존 이미지를 약간 수정하도록 요청하는 방법 미드저니에서 여러 이미지에 일관된 문자를 사용하려면 어떻게 해야 하나요? 미드저니에서 기존 이미지 몇 개를 하나로 병합하는 방법은 무엇인가요? 미드저니 명령어 목록 미드저니의 소스로 내 이미지를 사용하려면…

  • |

    최고의 스테이블 디퓨전 프롬프트 만드는 법

    스테이블 디퓨전, DALL-E, 미드저니와 같은 AI 이미지 생성기를 사용해 본 적이 있다면 프롬프트가 얼마나 중요한지 알 수 있을 것입니다. 잘 표현된 프롬프트는 아이디어를 멋진 이미지로 만들 수도 있고, 너무 많은 손가락이 나를 쳐다보는 기묘한 계곡의 괴물을 만들 수도 있습니다. 사람들은 2022년 스테이블 디퓨전이 출시된 이후 이상적인 결과를 얻기 위한 최선의 방법을 찾기 위해 노력해 왔으며,…

  • 메타, 그림에 생명을 불어넣는 AI 도구 출시

    메타는 최근 AI 기반 애니메이션 툴인 Animated Drawings를 오픈소스로 공개하며 다시 한 번 세계를 놀라게 했습니다. 이 도구는 그림에 존재하는 그림을 해독하고, 배경에서 분리하고, 관절 제어 기능을 부여하고, 다양한 방식으로 애니메이션을 적용할 수 있는 놀라운 기능을 갖추고 있습니다. 이제 자랑스러운 부모는 자녀의 예술 작품을 도구의 웹사이트에 업로드하고 춤추고, 건너뛰고, 점프하는 등 살아 움직이는 캐릭터로 변신하는…

  • |

    패딩 입은 교황 프란치스코

    미드저니 배우기 미드저니, 무료 체험판 중단 미드저니를 위한 최고의 리소스 미드저니, 최고의 프롬프트 사이트 추천 미드저니와 달리, 상위 50개 텍스트-이미지 변환 프롬프트 미드저니에서 기존 이미지를 약간 수정하도록 요청하는 방법 미드저니에서 여러 이미지에 일관된 문자를 사용하려면 어떻게 해야 하나요? 미드저니에서 기존 이미지 몇 개를 하나로 병합하는 방법은 무엇인가요? 미드저니 명령어 목록 미드저니의 소스로 내 이미지를 사용하려면…

  • 텍스트를 올바르게 렌더링할 수 있는 텍스트-이미지 변환 모델을 출시하는 Stability AI

    오늘 두 가지 모델 릴리스를 통해 두 가지를 소개해드리겠습니다. 첫 번째는 새로운 텍스트-이미지 변환 모델인 DeepFloyd IF로, 우리 모두가 기다려온 순간입니다. 실제로 생성된 이미지에서 텍스트를 제대로 렌더링할 수 있습니다! 드디어! (손가락에 대한 소식은 아직 없습니다…) 둘째, StableVicuna라는 언어 모델을 오픈소스화했는데, 이는 최초의 대규모 인스트럭션 미세 조정 및 RLHF 모델이라고 주장하고 있습니다. 허깅 페이스에서도 사용할 수…